
LLM(大型語言模型,Large Language Model)做的事情,乍看之下很像接龍:它讀取目前已有的 token,根據機率預測下一個 token,再把預測結果接回去,反覆直到回答結束。token 可以先理解成模型處理文字時使用的小單位,它也會佔用這一輪的 context 預算。
這個接龍玩家不會自己跑去資料夾裡找資料,也不知道上一段對話以外的事情。它只會根據這一輪看得到的文字,繼續猜下一個 token。
在網頁 AI 裡,模型、runtime、記憶體和伺服器都被服務商藏在後台。搬回本機後,模型檔案、runtime、記憶體、速度和資料是否外送,都要自己看得見、管得住。
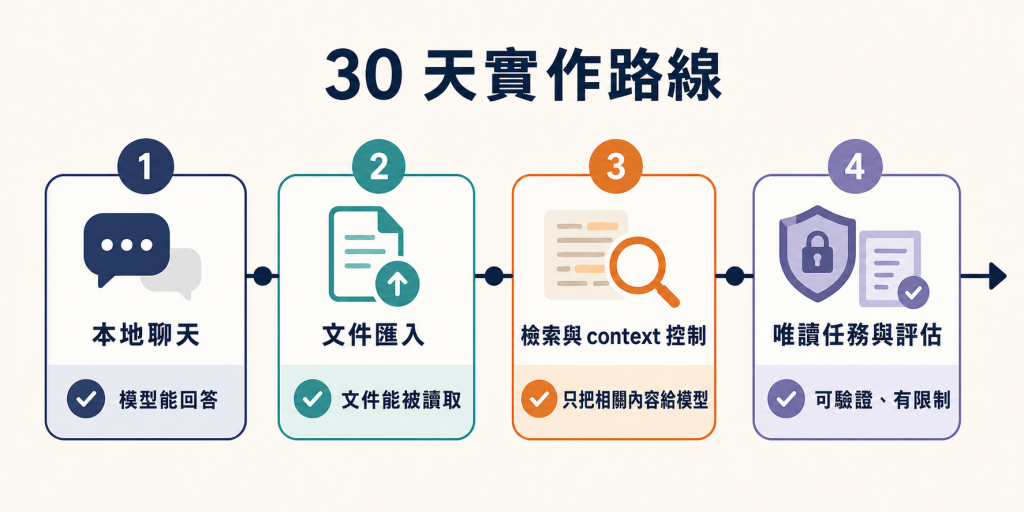
這 30 天會從能回答問題的本地模型開始,逐步加入文件匯入、可重建索引、檢索、context budget、附來源回答,以及受限制的唯讀工具。最後留下的是一個知道去哪裡找資料、只拿相關證據、找不到就停下來的本地 agent。
Repository:https://github.com/gilbertytw-lab/ai-engineering-frontier.git
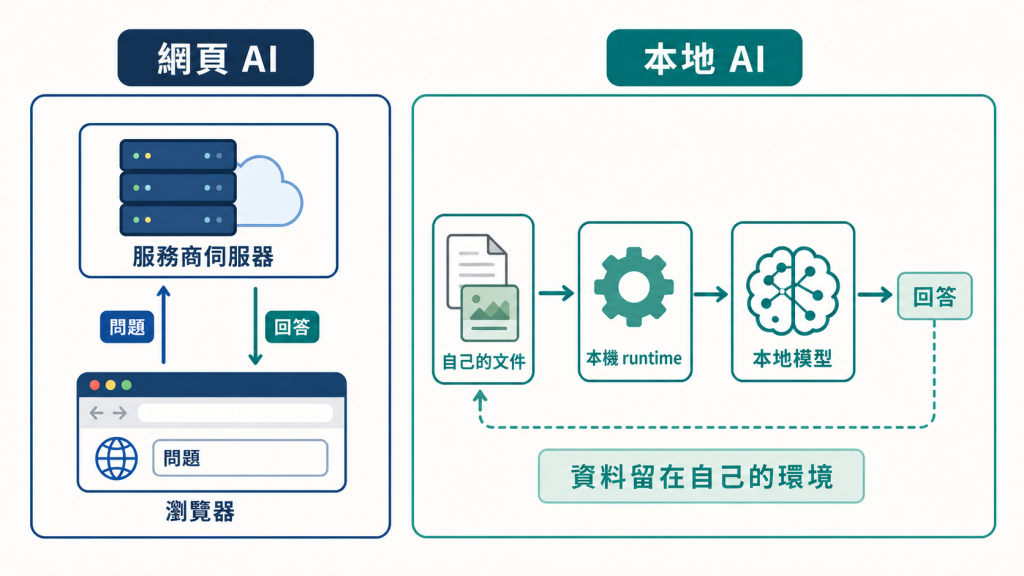
接龍玩家本身只負責根據目前看到的文字產生下一個 token。模型檔案保存訓練後的參數;runtime(模型執行環境)負責載入模型、整理輸入、執行推論,再把結果交回呼叫端。
一次最基本的本地對話,大概會經過這幾步:
模型檔案
  → runtime 載入模型
  → 把問題轉成模型看得懂的格式
  → 模型逐步產生文字
  → runtime 把結果顯示出來
網頁 AI 把這些事情包在服務商的伺服器裡。我們只需要開瀏覽器、輸入問題;本地 AI 則把其中一部分工作搬回自己的電腦,所以也必須自己處理模型版本、記憶體、儲存空間和執行速度。
這不代表本地模型一定比較好。它的好處是資料可以留在自己的環境,模型和設定也比較容易自己控制;代價是電腦要負責這些工作。記憶體不夠,模型可能載不進去;就算載得進去,也可能慢到不適合日常使用。
另外,「資料在本機」也不是一句保證。只要 runtime、外掛或我們自己寫的程式還會把問題送到外部 API,資料就可能離開電腦。這個系列會把本地模型、文件和檢索流程拆開記錄,之後才有辦法確認每一段資料去了哪裡。
Local Engineering Knowledge Assistant 會把原始文件、整理頁、索引、檢索和本地模型接成一條可追蹤的流程。讀者把自己的 Markdown 或文字文件放進知識庫,系統先找到相關證據,再交給模型整理回答;需要執行任務時,模型只能使用明確定義、可驗證的唯讀工具。
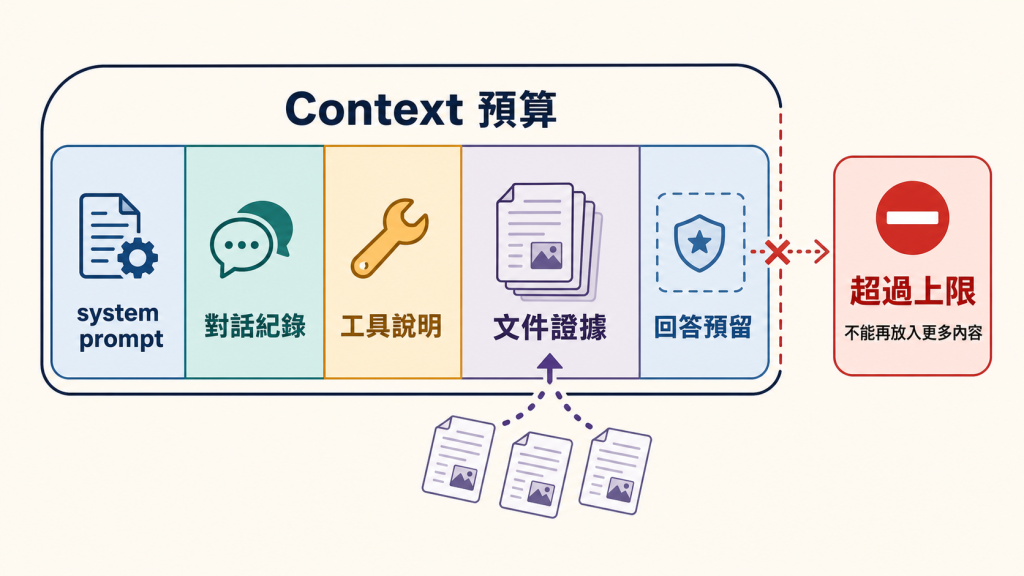
知識助理每次只把相關內容送進模型。系統先從原始文件與整理頁的索引中找出候選片段,再把選出的證據、必要的 system prompt、對話歷史和工具說明組成這一次請求的 context。Context 可以先理解成模型這一輪工作時看得到的文字範圍。
Context 是固定預算。若本機 runtime 目前只提供 32K,就要把 system prompt、工具描述、對話歷史、檢索證據和回答空間一起分配;文件放得太少會漏掉證據,放得太多則會增加延遲,也可能讓重要內容被淹沒。
這 30 天會走過四段:先讓本地模型能穩定聊天,再匯入並整理文件;接著建立檢索與 context budget,只把相關證據交給模型;最後加入唯讀任務、輸入驗證、步數限制、拒答行為與評估。每一步都留下當時的程式和結果,你可以在中途停下來,也可以換成自己的文件繼續做。
我的筆電是 MacBook Air,10 核心、32 GB 記憶體。這次先把 Qwen/Qwen3.8-27B 當作 target model,Apple Silicon 從 mlx-community/Qwen3.8-27B-4bit 開始測試;DFlash2 只列為後續可選的 draft model。
27B 代表模型大約有 270 億個參數。若使用 4-bit 量化版,只看模型權重可以先用「27B × 4 ÷ 8 ≈ 13.5 GB」粗估;實際執行還要加上 runtime、KV cache、系統和其他程式使用的記憶體。因此 32 GB 不等於有 32 GB 可以全部拿來放模型。Qwen3.8-27B 的模型規格原生支援更大的 context,但本系列先把本機 runtime 的 32K 當作實際限制,是否能穩定使用更長 context 仍要靠測試確認。
硬體較弱時,可以換成較小的模型;文件格式、索引、檢索、context 組裝、回答和工具邊界仍然照同一套流程進行。這個系列固定的是資料流與可驗證的介面,不把單一模型當成必要條件。
下一篇先做最小驗證:在本機叫起模型,記下實際使用的模型、runtime、硬體,以及第一組輸入與輸出。


 iThome鐵人賽
 看影片追技術